你的爬虫之所以一跑就被拔网线,主要踩了三个雷:
-
“裸奔”请求:没改默认的 User-Agent,或者带着极具辨识度的 Python 默认 TLS/JA3 指纹,服务器一眼就认出你是脚本。
-
固定 IP 轰炸:用同一个家庭宽带或机房 IP,在一分钟内发起了人类根本无法完成的几百次请求,触发了 Nginx 漏桶算法限流。
-
贪便宜用烂代理:用了网上免费的透明代理,不仅把你的真实 IP 透传给了目标网站,代理 IP 本身也早就在各大厂的黑名单里了。
解药:动态高匿住宅代理池 + 随机指纹库 + 合理并发控制,缺一不可。
如果你是个刚学完 requests 或者 Scrapy 的新手,第一反应多半是找个网站练练手。你兴奋地写下一个 for 循环,按下回车,看着终端里疯狂滚动的 200 状态码,觉得自己简直就是数字世界的黑客帝王。
但好景不长,五分钟后,红色的报错刷屏了——403 Forbidden、10054 Connection Reset、甚至直接给你返回一个 Cloudflare 的验证码页面。
很多人跑来问我:“老哥,我明明已经设置了 time.sleep(1),怎么还是被封了?”
这几年我带数据采集团队,和各大电商、社交平台的反爬安全工程师斗智斗勇,我太清楚他们设卡拦截的底层逻辑了。今天这篇文章不跟你扯什么书本理论,我直接把这几年我们实战踩过的坑、烧掉的几万块钱代理费换来的经验全盘托出。照着这套逻辑去调优,你的爬虫存活率至少翻五倍。
一、 真实踩坑血泪史:从公司断网到差点被请去“喝茶”
讲反爬机制前,先说个我早期带团队时闹出的极其丢人的事故。
那时候我们接了一个跨境电商竞品分析的单子,要求抓取某独立站全类目的价格数据。当时组里一个刚招来的实习生,为了赶进度,直接在公司的局域网里开了一台服务器,起了 50 个线程并发去怼那个目标网站。
结果呢?不到十分钟,爬虫全线崩溃报错。这还不算完,目标网站的安全策略极其硬核,直接通过边界网关协议把我们公司的出口公网 IP 给彻底拉黑了。整个办公室,从老板到财务,一整天都打不开那个竞品网站,甚至连带着部分使用同源 CDN 的海外网站也访问受阻。老板气得差点没把我当场开除。
这就是典型的毫无敬畏之心的下场。你把别人的服务器当 ATM 机疯狂取钱,别人不报警抓你就不错了。这不仅是技术问题,更涉及到极其敏感的合规底线。如果不清楚自己抓数据的行为算不算越界,我强烈建议你在动手前,先去认真研读一下这篇关于 2026年最新网络爬虫法律边界与合规深度解析,搞清楚什么是“不当得利”,什么是“破坏计算机信息系统”,千万别为了几百块钱的私活把自己送进橘子。
二、 你的爬虫为什么像在“裸奔”?起底大厂的三层反爬防线
知己知彼,百战不殆。当你的请求到达目标服务器时,它会经历什么?
1. 第一层:频控与并发限流 (Rate Limiting)
这是最基础的 IP 封锁逻辑。几乎所有大型网站的前端都挂着 Nginx 或类似的反向代理,它们通常配置了漏桶(Leaky Bucket)或令牌桶(Token Bucket)算法。
-
人话解释:系统规定一个 IP 一秒钟最多只能看 3 页。你的脚本一秒钟并发了 50 个请求,Nginx 一看,这绝对不是人手能点出来的速度,直接在防火墙层面把你的 IP 关进“小黑屋”(通常是返回 429 Too Many Requests,接着就是永久 403 甚至 RST 阻断)。
2. 第二层:HTTP 头部与 TLS 指纹审查 (JA3 Fingerprinting)
很多人知道要改 User-Agent,把自己伪装成 Chrome 浏览器。但这在 2026 年的今天早就没用了。
现在的 WAF(Web 应用防火墙,如 Cloudflare、Akamai)不仅看你自称是谁,还要看你的“骨架”。
-
TLS 指纹暴露:当你用 Python 的
requests库发起 HTTPS 请求时,底层的 OpenSSL 在和服务器建立加密连接(握手)时,会发送一套特定的加密套件列表。这套列表的组合被称为 JA3 指纹。Python 默认的指纹和真实的 Chrome 浏览器指纹完全不同! -
结果就是:你穿着写着“我是 Chrome”的外套(User-Agent),但安全网关扫描了你的骨架(TLS 指纹),冷笑一声:“小样,你明明是个 Python 脚本”,然后直接赏你一个验证码。
3. 第三层:行为轨迹与 JS 挑战
如果你用的是 Selenium 或 Playwright 这类自动化工具,觉得可以绕过底层指纹,那你就大错特错了。
网站会通过下发一段复杂的 JavaScript 代码(俗称 JS 挑战),检测你的浏览器有没有安装特定的插件、检测 window.navigator.webdriver 属性是否为 true。甚至会记录你的鼠标滑动轨迹(是否绝对呈直线)、点击的时间间隔。只要有一项不符合“碳基生物”的特征,封 IP 没商量。
三、 别被骗了:免费代理池为什么越用越封?
发现固定 IP 被封后,新手的下一个动作通常是去百度搜“免费代理 IP”,然后兴冲冲地爬拉一堆 IP 存进数据库,美其名曰“自建代理池”。
听我一句劝,这是在白费功夫,甚至是在引火烧身。
网络上的代理分为三种级别,你要是没搞懂其中的区别,死都不知道怎么死的:
| 代理级别 | 你的真实 IP 是否可见 | 目标服务器能否发现你用了代理 | 死亡率 |
| 透明代理 (Transparent) | 可见!(在请求头暴露 HTTP_X_FORWARDED_FOR) | 能发现 | 100% 见光死 |
| 匿名代理 (Anonymous) | 隐藏 | 能发现(暴露了 HTTP_VIA 字段) | 极高(很多大厂直接拒绝代理 IP) |
| 高匿代理 (Elite) | 完全隐藏 | 无法发现(看起来就像真实的普通网民) | 极低,爬虫必备 |
你从免费网站上刮下来的 IP,95% 都是透明或低劣的匿名代理。不仅如此,这些 IP 因为免费,早就被成千上万个灰黑产团队拿去扫库、发垃圾邮件、撞库,它们的 IP 信誉(IP Reputation)极度恶劣。各大云服务商的防火墙早把它们列入黑名单了,你拿这种 IP 去请求,连网站的大门都进不去就被直接 Drop 了。
所以,想要真正在企业级业务中存活,你必须花钱去购买商用的动态住宅代理(Residential Proxies)。这类代理的 IP 归属于真实的家庭宽带(ISP),信誉度极高,目标网站会认为你是某个在家用电脑上网的普通用户。
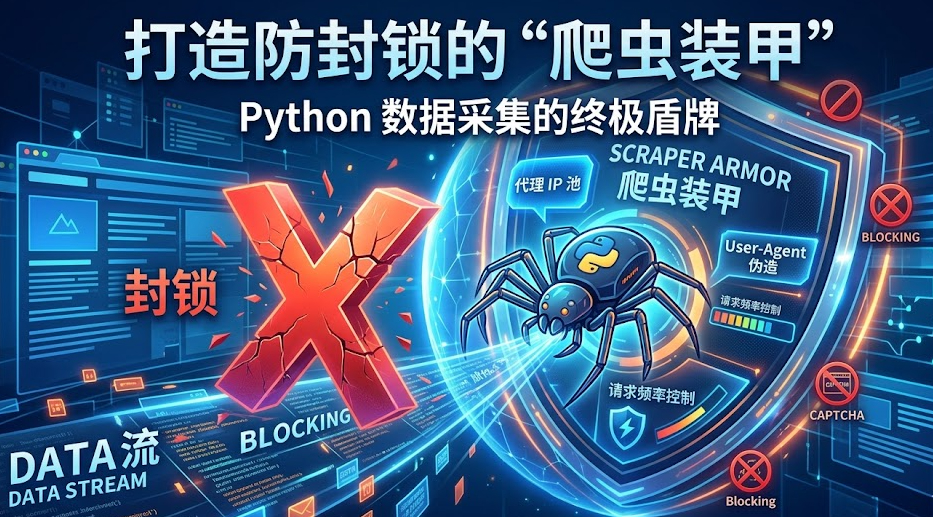
四、 进阶实操:如何打造一套防封锁的“爬虫装甲”?
如果你正在搭建一个新的爬虫项目,首先确保你的开发环境是最新的。如果你还没准备好环境,可以在动手前前往 Python下载 获取最新的官方稳定版,很多旧版本的库在处理现代异步并发时容易出各种幺蛾子。
然后下面通过组合拳,打造一个高存活率的爬虫系统。
核心解法 1:彻底伪装你的 HTTP 指纹
不要只写一个死板的 User-Agent。你需要引入 fake-useragent 库,并在每一次请求时动态切换。
更高阶的做法是解决我们前面提到的 TLS 指纹问题。在 Python 中,建议放弃原始的 requests,改用 curl_cffi 或者 httpx(配合特定 transport),这些库可以完美模拟 Chrome 或 Safari 的底层 TLS 指纹(即 JA3 欺骗)。
Python
# 一段概念演示:使用 curl_cffi 模拟真实浏览器底层指纹
from curl_cffi import requests

# impersonate="chrome110" 会让底层的 TLS 握手完全变成 Chrome 110 的形状
response = requests.get(
 "https://target-website.com",
 impersonate="chrome110",
 proxies={"http": "http://your_proxy_ip:port", "https": "http://your_proxy_ip:port"}
)
print(response.status_code)
核心解法 2:接入高质量动态代理池
商用代理池通常会提供一个唯一的“入口 IP”,并在其后端自动为你轮换出口 IP。每次你的爬虫发送请求时,你不需要自己去维护几千个 IP 的死活,代理厂商的网关会自动把你的请求转发到一个全新的住宅 IP 上。
实战防坑建议:很多时候爬虫报错不是网站封了你,而是代理商给的那个节点刚好掉线了。所以在代码里,一定要写好 try-except 异常捕获机制,并结合重试逻辑(Retrying)。遇到代理连接超时,不要让整个程序崩溃,休息两秒,换个代理继续抓。
核心解法 3:加入“人类抖动”与休眠策略
别再用 time.sleep(2) 这种固定延迟了。目标网站的数据分析师只要调出日志,看你每两次请求的间隔都是绝对的 2.000 秒,立刻就能写条正则规则把你干掉。
引入随机休眠时间,模拟人手翻页的停顿感:
time.sleep(random.uniform(1.5, 4.3))
如果是用自动化工具,加入鼠标的贝塞尔曲线滑动轨迹,以及随机的上下滚动页面的动作,这能骗过 80% 的前端行为检测脚本。
五、 防封 IP 与高并发爬取 SOP 检查清单 (Checklist)
每次下面新的爬虫脚本上线到服务器前,我们团队都会严格核对以下 SOP 清单。漏掉一条,都可能导致项目白干:
-
指纹模拟:是否已检查 User-Agent 库更新?是否使用了支持 TLS/JA3 指纹伪装的底层请求库?
-
代理质量:使用的代理是否为高匿代理(Elite)?是否排除了透明代理泄露本机 IP 的风险?
-
异常捕获:代码中是否完善了
Timeout,ConnectionError,ProxyError的异常捕获与重试机制(如使用 tenacity 库)? -
并发速率:单目标域名的 QPS(每秒请求数)是否控制在合理阈值?是否加入了随机波动休眠时间(Random Sleep)?
-
响应校验:不要只判断状态码是否为 200!必须校验返回的 HTML 中是否包含“验证码”、“滑块”、“系统繁忙”等关键词,防止爬下来一堆无效脏数据。
-
合规与红线审查:抓取的数据是否包含用户隐私、商业机密?是否严格遵循了目标网站的
robots.txt协议边界?
六、 常见问题解答 (FAQ)
Q1:为什么我明明加了高匿代理池,还是经常弹出 Cloudflare 的五秒盾(验证码)?
这是因为你购买的代理 IP 信誉(IP Fraud Score)不够干净。很多廉价的住宅代理其实被大量的灰黑产团队共享使用过,Cloudflare 对这种 IP 是天然不信任的。其次,你的 TLS 指纹可能已经暴露了你是脚本。解法是:升级代理质量,或者引入如 Playwright + Stealth 插件等真实的浏览器渲染引擎来硬刚验证码。
Q2:对于需要账号登录才能爬取的数据,封 IP 会连累我的账号被封吗?
绝对会!这是非常高危的操作。 如果网站检测到你的账号在极短的时间内从美国 IP 跳到日本 IP,再跳到英国 IP(因为你的代理池在疯狂轮换),系统的风控引擎会立刻判定你的账号被盗或者在进行恶意抓取,直接封禁账号。
对于需要登录的抓取,必须采用“账号与 IP 强绑定”策略:即 Account A 在整个生命周期内只能使用固定的 Proxy IP A(或者限定在同城 IP 段),绝不能乱跳 IP。
Q3:我想爬的数据量上千万,单台机器挂代理实在太慢了,怎么解决?
单机的网络和 CPU 终究是有上限的。到了这个量级,你必须抛弃简单的 while 循环,转向分布式架构。使用 Scrapy-Redis 或者 Celery 结合消息队列(如 RabbitMQ),将爬取任务(URL 分发)部署在主节点,然后启动几十个配置了独立代理和指纹的从节点(Worker)并发去消化队列。这是商业级数据采集的唯一出路。
📚 参考来源(权威背书)
-
RFC 7239 & 7230(HTTP/1.1 标准文档):关于 X-Forwarded-For 与代理报文转发机制的底层规范,此规范解释了透明代理为何会暴露真实 IP。
-
Scrapy 官方架构文档:Scrapy Architecture(本文关于下载器中间件处理代理轮换及异常重试架构的行业技术参考)。