在数据被称为“新时代石油”的今天,网络爬虫技术已经成为获取互联网公开信息最重要、最基础的手段之一。对于广大程序员、数据分析师甚至科研人员来说,提到爬虫,首先想到的必然是 Python。然而,随着全球对数据安全、个人隐私以及知识产权保护的日益重视,一个悬在所有开发者头顶的终极问题不断被提及:Python爬虫合法吗?
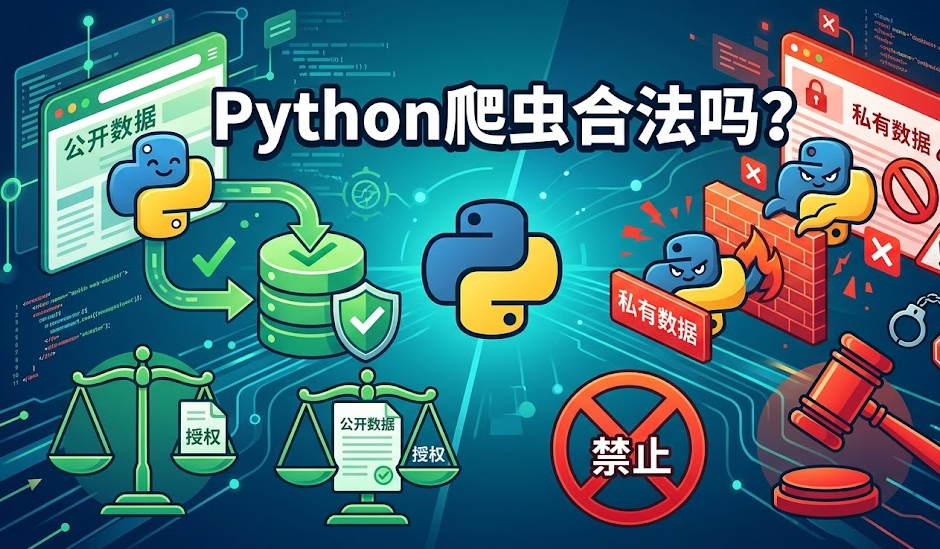
直接给出结论:Python爬虫技术本身是完全中立且合法的。 爬虫只是一种自动化的网络数据抓取工具,就像一把菜刀,技术本身不带有任何违法属性。但是,使用Python爬虫的行为是否合法,完全取决于您“爬取了什么数据”、“使用了什么手段爬取”以及“爬取数据后用来干什么”。 只要触碰了数据隐私、系统安全或不正当竞争的红线,原本合法的技术工具就会变成违法犯罪的作案工具。
本文将面向所有普通用户、开发者及企业管理者,通俗易懂地深度剖析 Python爬虫的底层逻辑、法律边界、合规准则,并提供一套权威、可信、专业的实战避坑指南,帮助您在 2026 年复杂的法律环境中安全前行。
一、 拨开迷雾:什么是 Python爬虫?为什么总是它?
要探讨合法性,我们首先需要理解技术本身。
1. 爬虫的基本原理
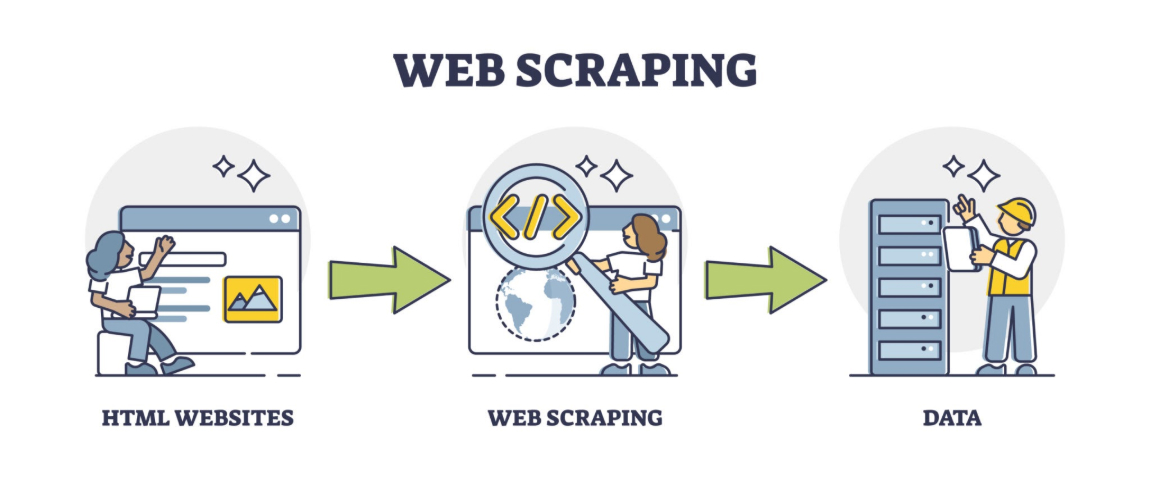
网络爬虫(Web Crawler或Web Scraper),本质上是一个自动模拟人类浏览网页行为的计算机程序。当您使用浏览器访问一个网页时,您的浏览器会向服务器发送一个请求,服务器将网页的代码(HTML/CSS/JavaScript)返回给您,浏览器再将其渲染成漂亮的网页。
Python爬虫做的事情一模一样,只不过它去掉了“用眼睛看”的过程。它以极快的速度向目标服务器发送请求,静默下载网页代码,并通过预先写好的规则,将其中有价值的数据(如商品价格、新闻标题、股票代码)提取出来并保存到数据库中。
2. 为什么 Python 成了爬虫的代名词?
Python 之所以成为网络爬虫领域的绝对霸主,得益于其简洁的语法和极其繁荣的第三方开源生态。
-
请求库强大: 像
requests、httpx这样的库,让发送网络请求变得像写英语句子一样简单。 -
解析库丰富:
BeautifulSoup、lxml可以极其高效地从杂乱的网页代码中精准剥离出目标数据。 -
自动化框架成熟:
Scrapy提供了工业级的分布式抓取能力,而Selenium和Playwright则可以完美模拟真实用户的鼠标点击、滑动等操作,应对复杂的动态网页。
如果您还没有安装 Python 或者希望获取最新的开发环境,建议您通过正规渠道进行 Python下载,配置好安全、纯净的开发环境,这是进行所有合规开发的第一步。
二、 判定 Python爬虫合法性的“核心三要素”
在法律实务中,判定一个 Python爬虫项目是否违法,通常不会一刀切,而是会从以下三个核心维度进行深度考量。这也正是您在编写每一行爬虫代码前,必须问自己的三个问题:
要素一:您爬取的是“什么数据”?(数据性质)
这是最关键的红线。互联网上的数据并非全都可以随意拿走。
-
公开且无版权争议的数据(安全区): 例如国家统计局公布的宏观经济数据、公开的天气预报信息、不受著作权保护的简单事实和公式。爬取这类数据通常是极其安全的。
-
受著作权保护的作品(高风险): 例如原创小说、付费音乐、高清摄影图片、深度行业报告等。如果您使用 Python爬虫大量抓取这些内容并据为己有,即使数据是公开展示的,也极易构成侵犯著作权(版权)。
-
个人隐私信息(绝对红线): 包括但不限于用户的姓名、身份证号、手机号码、家庭住址、消费记录、聊天记录等。无论是欧洲的 GDPR 还是全球各地的个人信息保护法,都严厉禁止未经授权的个人数据抓取。哪怕这些数据是用户自己展示在公开主页上的,大规模的爬取和分析也极易触犯法律,甚至构成刑事犯罪。
-
企业商业秘密与非公开数据(绝对红线): 如果 Python爬虫通过某些手段获取了目标网站并未向公众开放的数据(例如后台交易流水、内部员工通讯录、未发布的促销计划),这属于窃取商业机密或非法获取计算机信息系统数据。
要素二:您是“怎么爬”的?(技术手段)
合法的数据,如果用了非法的手段去获取,同样会面临严厉的法律制裁。
-
遵守 Robots.txt 协议(君子协定): 这是互联网界的一个通行行业规范。网站所有者会在网站根目录下放置一个
robots.txt文件,里面声明了哪些页面允许爬虫访问,哪些页面禁止访问。如果一个网站的 Robots 协议明确写了
Disallow: /(禁止所有爬虫访问),而您的 Python爬虫依然强行抓取,虽然这在某些国家不直接等同于刑事犯罪,但会被视为“恶意爬取”,在民事诉讼中处于绝对劣势。 -
避开甚至破坏反爬措施(危险行为): 目标网站为了保护服务器和数据,通常会设置反爬虫机制(如验证码、IP封禁、账号登录限制、参数加密)。如果您的 Python爬虫使用了伪造 IP 代理池、破解验证码算法、逆向工程破解加密接口等手段“强行突破”这些防护措施,在法律上往往会被认定为“破坏计算机信息系统”或“非法侵入计算机信息系统”,这是极其危险的刑事犯罪边缘。
-
无节制的并发请求(极度危险): 爬虫的速度远超人类。如果您的 Python爬虫毫无节制地以每秒数千次的速度向目标服务器发送请求,导致对方服务器 CPU 爆满、带宽耗尽甚至瘫痪崩溃(类似于 DDoS 攻击),这就不仅是爬虫问题了,而是直接构成了破坏计算机信息系统罪,必将受到法律严惩。
要素三:您爬完数据“用来干什么”?(使用目的)
数据的用途,往往决定了民事责任的归属。
-
个人学习与非盈利科研(相对安全): 如果您写一个 Python爬虫只是为了完成大学的数据分析作业,或者抓取几百张公开图片用来练习本地的图像识别模型,且不公开传播、不用于盈利,这通常属于“合理使用”的范畴,风险极低。
-
直接商业变现与售卖(高风险): 将爬取来的数据直接打包出售,或者建立一个与被爬取网站完全一样的“镜像网站”来赚取广告费。这种“不劳而获”的行为直接损害了原网站的商业利益。
-
恶意商业竞争(不正当竞争): 例如,A外卖平台每天使用 Python爬虫疯狂抓取B外卖平台的所有商家菜品和实时价格,然后针对性地制定降价策略,或者直接将对方的商户数据搬运到自己的平台上。这种行为属于典型的“搭便车”,严重违反了诚实信用原则,极易引发《反不正当竞争法》的诉讼,且败诉率极高。
三、 Python爬虫与人工智能:共生还是掠夺?
在 2026 年的今天,探讨 Python爬虫的合法性,就不得不提及其与人工智能(AI)尤其是大型语言模型(LLM)的深度绑定关系。
AI 模型的训练需要海量的数据“喂养”。无论是 ChatGPT 还是各种垂直领域的行业大模型,其知识底座的大部分语料,都是依靠庞大的网络爬虫矩阵从整个互联网上夜以继日地抓取而来的。在这个过程中,Python 扮演了极其核心的角色。如果您想深入了解为什么 Python 在这个流程中不可替代,您可以阅读这篇深度文章:Python在AI领域重要吗?深度解析人工智能的首选编程语。
然而,AI 时代的大规模数据抓取,正面临着前所未有的法律挑战:
-
版权争议: AI 公司使用 Python爬虫抓取受版权保护的新闻、小说、代码库来训练模型,生成的内容又与原作品具有竞争关系。全球各地爆发了大量创作者起诉 AI 科技巨头的版权侵权案件。
-
付费墙与反AI爬虫: 为了防止数据被 AI 免费白嫖,越来越多的主流网站(如纽约时报、Reddit、Twitter)开始修改他们的 Robots 协议,明确禁止 AI 爬虫(如 OpenAI 的 GPTBot)抓取其内容,并设立了严格的 API 收费墙。
因此,如果您目前的 Python爬虫项目是用于收集机器学习的数据集,您需要比以往任何时候都更加谨慎。单纯声称“用于技术研究”,在今天已经很难完全规避商业侵权或违反网站服务条款(Terms of Service)的风险。
四、 2026 最新 Python爬虫合规实战避坑指南(核心必读)
明确了法律红线后,
法则 1:永远优先查看 Robots.txt 和服务条款(ToS)
在对任何网站动手之前,在浏览器中输入 https://www.目标网站.com/robots.txt。仔细阅读其中的 User-agent 和 Allow/Disallow 规则。同时,花三分钟浏览该网站底部的“用户协议”或“服务条款”,如果条款中明确写有“严禁使用任何自动化脚本、爬虫抓取本网站数据”,请您务必三思而行。商业化项目应坚决避免碰触此类网站。
法则 2:控制抓取频率,保持极致的“温柔”
这是最能体现爬虫开发者职业素养的一条。不要把您的 Python爬虫当成网络攻击武器。
-
在代码中加入
time.sleep(),在每次请求之间随机暂停 2 到 5 秒甚至更长。 -
尽量选择在目标网站业务低谷期(例如凌晨 2 点到 5 点)进行抓取。
-
如果网站提供了官方的 API 接口(即使有访问速率限制),永远优先使用官方 API,而不是去暴力解析 HTML 网页。
法则 3:诚实地表明自己的身份(User-Agent)
在发送 HTTP 请求时,不要总是伪装成正常的 Chrome 或 Safari 浏览器(虽然这在技术上很容易做到)。如果您正在为一个正当的项目(如学术研究或搜索引擎)编写爬虫,建议在请求头的 User-Agent 中诚实地写入您的爬虫名称、用途以及联系邮箱(例如:User-Agent: MyResearchBot/1.0 (+http://www.mywebsite.com/bot-info; [email protected]))。当您的爬虫意外给对方服务器造成压力时,对方管理员可以通过邮箱联系您,而不是直接报警。
法则 4:绝不碰个人隐私数据
无论目标网站是否存在安全漏洞,无论这些数据多么有商业价值,绝对不要编写 Python爬虫去抓取包含姓名、身份证、电话、地理位置、私密聊天记录等在内的个人敏感信息。在数据合规日益严格的今天,这是一条绝对不可逾越的高压线。
法则 5:不要突破访问控制(绕过登录或破解加密)
如果一个页面的数据需要用户注册、输入密码登录、甚至购买 VIP 才能查看,那么这些数据就不属于“公开数据”。如果您使用 Python 脚本自动化模拟登录,甚至通过逆向工程手段破解了对方的数据加密算法(例如解密 JS 混淆参数)来获取数据,这种行为极易被定性为“非法获取计算机信息系统数据”。
法则 6:数据使用须谨慎,避免不正当竞争
抓取到的数据不要直接用于构建与被抓取方形成直接竞争关系的产品。例如,不要把抓来的房产信息直接原封不动地展示在自己的房产网站上;不要把抓来的用户评价直接复制到自己的电商平台上作为刷单工具。对数据进行深度加工、匿名化处理和聚合分析,产生新的增值价值,才是合规利用数据之道。
法则 7:保留网页快照与日志(证据保全)
在运行爬虫时,建议将爬取的日志(包括时间、目标 URL、响应状态码)记录下来。如果被抓取的网页存在明显的版权声明或数据来源标注,在抓取时应尽量保留这些溯源信息。一旦发生民事纠纷,这些日志能够证明您的抓取行为是克制的、有选择的,并在一定程度上降低恶意侵权的嫌疑。
五、 全球视野:权威法律与技术规范参考资料
Python爬虫的合法性问题不仅是一个技术话题,更是一个复杂的跨司法管辖区的法律话题。为了让您在从事数据采集工作时拥有更权威的判断依据,建议您深入了解以下全球公认的规范与法律要求。以下提供 3 个极具价值的外部参考链接,确保您的知识库保持专业和准确:
-
Robots 协议官方说明标准:
想要彻底弄懂
robots.txt到底能限制什么、不能限制什么?您可以查阅记录互联网规则的老牌权威站点 The Web Robots Pages。这里有关于爬虫协议最原始、最准确的技术规范定义。 -
通用数据保护条例 (GDPR) 官方信息源:
如果您身处欧洲,或者您的 Python爬虫试图抓取包含欧盟公民信息的网站,您必须严格遵守 GDPR。该网站提供了法案的完整条款,详细解释了何为“个人数据”以及自动处理数据的严格限制。
-
维基百科关于 Web Scraping 的法律争议专栏:
想要了解全球历史上著名的爬虫诉讼案(如美国的 hiQ Labs 诉 LinkedIn 案、eBay 诉 Bidder’s Edge 案)的判决结果及其深远影响?维基百科的这一专属章节提供了详尽的历史脉络和法律判例分析。
六、 总结:戴着镣铐跳舞,方能长久前行
回到我们最初的问题:Python爬虫合法吗?
答案已经非常清晰:技术无罪,合规有道。 Python 赋予了我们自动化获取互联网无尽宝藏的强大能力,但这并不意味着互联网是一个可以肆意掠夺的“无主之地”。
在 2026 年更加完善和严格的数据保护法规下,优秀的 Python 爬虫工程师,不仅需要掌握高超的并发编程、反爬突破与数据解析技术,更需要具备极其敏锐的法律意识和道德底线。
把爬虫当作一种“数据交流”的手段,而不是“数据抢劫”的工具;对目标服务器保持敬畏,对知识产权保持尊重,对个人隐私保持远离。严格遵守本指南中提出的七大法则,您就可以在确保自身绝对安全的前提下,尽情享受 Python 爬虫技术带来的高效与便捷,在浩瀚的数据海洋中挖掘出属于您的真正价值!