省流快速指北:选对存储方案,能帮你省去90%的数据清洗时间。直接抄作业:
- 数据量 < 10万,自己看:用 CSV。轻量、极速,千万记得用
utf-8-sig编码,否则用Excel打开必定乱码。- 需要发给非技术人员/产品经理:用 Excel (.xlsx)。但记住单表极限是104万行,且千万别在爬虫的
for循环里频繁读写Excel,硬盘会吃不消。- 数据量 > 10万,且字段固定(如商品价格、电商SKU):上 MySQL。配合
executemany批量插入,加上唯一索引防重复。- 抓取API接口数据或嵌套层级深(如微博评论、动态长文本):无脑选 MongoDB。不用建表,字典(Dict)直接塞进去,爬虫工程师的终极救星。
我永远记得自己刚学爬虫那年犯的一个低级错误:为了抓取某电商网站的15万条商品评价,我写了个脚本,把数据全部追加到一个 Python 的 List 里,打算等全部爬完后再统一写入文件。
结果程序跑到第 14.8 万条的时候,因为遇到了一个生僻字导致解析抛出异常,脚本直接崩溃退出了。内存里的数据瞬间清零,白白浪费了 6 个小时的代理IP费和时间。
从那以后我才彻底明白:爬虫的核心不仅是“怎么抓”,更是“怎么安全、高效地存”。 很多网上的基础教程教你怎么发起请求、怎么解析页面,但在数据落地这一环却总是草草带过。如果你还没有掌握完整的爬虫闭环,强烈建议先复习一下这篇 Python怎么爬取网页数据?从零基础抓取 的实战全解。基础打牢后,我们直接进入正题——盘点现阶段主流的4种爬虫数据保存方案及其隐藏的坑。
(注:实操前请确保您的环境配置正确,若未安装环境,可前往官方渠道或可靠的 Python下载 站点获取最新版本的解释器。)
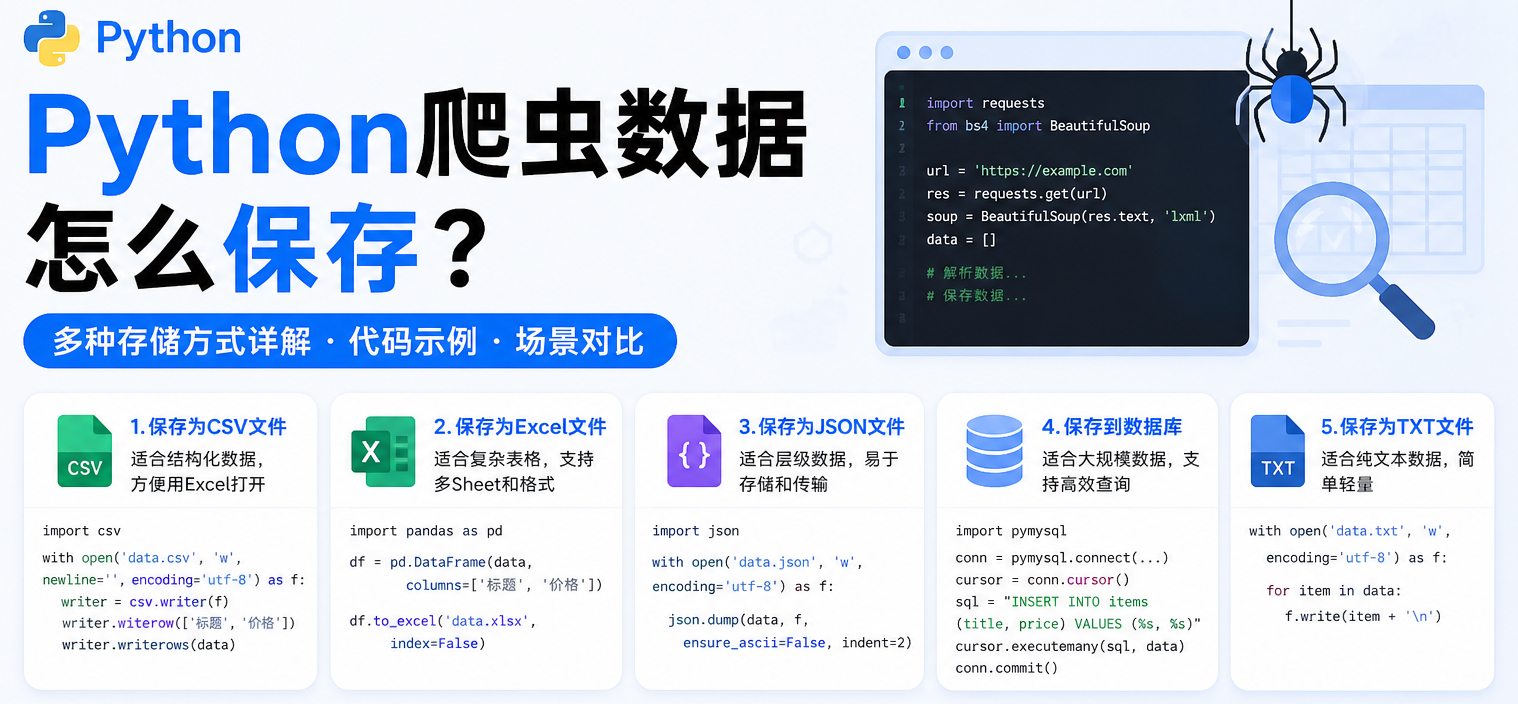
方案一:CSV —— 爬虫新手的“快乐文件”(轻量且极速)
CSV(逗号分隔值)本质上就是个纯文本文件。它的优势在于读写速度极快,不占用多余内存。你可以把它理解为没有格式、没有公式的“裸奔版”电子表格。
实战代码与正确姿势
Python 内置了 csv 模块,但在实际业务中,我更推荐直接用 pandas 库,代码不仅少,而且不容易在换行符上栽跟头。
import pandas as pd

# 假设这是你爬到的数据列表,里面嵌套了字典
data_list = [
 {'title': 'Python核心编程', 'price': 89.0, 'author': 'Wesley'},
 {'title': '流畅的Python', 'price': 108.0, 'author': 'Luciano'}
]

# 直接转为DataFrame
df = pd.DataFrame(data_list)

# 导出为CSV(注意这里的编码陷阱)
df.to_csv('books_data.csv', index=False, encoding='utf-8-sig')
💣 只有内行才知道的踩坑细节:
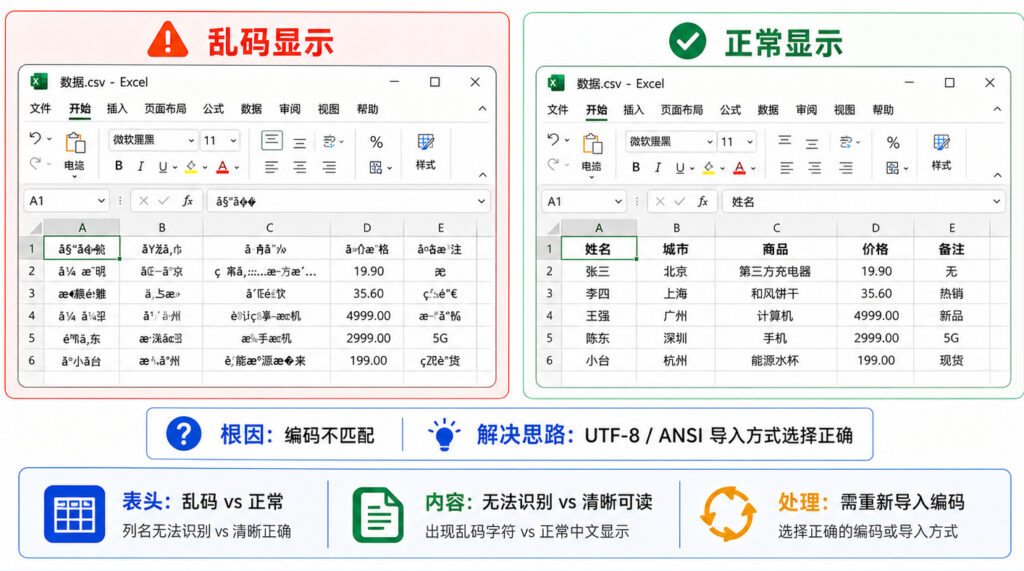
- 致命的乱码陷阱:很多新手会写
encoding='utf-8'。如果你只用记事本打开,没问题;但如果你的业务方习惯双击用 Excel 打开这个 CSV,里面绝对是乱码。必须使用utf-8-sig,它会带有 BOM 头,明确告诉 Windows 的 Excel 这是 UTF-8 编码。 - 边爬边存怎么写?:千万别每次写入都覆盖。如果你要实时保存,记得用追加模式
mode='a',同时加上判断:只有写第一行时才带表头 (header=True),后续追加不写表头。
方案二:Excel (.xlsx) —— 业务交付与产品经理的最爱
虽然程序员喜欢纯文本和数据库,但当你把爬虫结果交给产品经理、运营或甲方老板时,他们通常只会问一句:“能发个 Excel 给我吗?”
实战代码
写入 Excel 同样首推 pandas,底层依赖 openpyxl 引擎。
# 延续上面的 DataFrame (df)
df.to_excel('books_data.xlsx', index=False, sheet_name='技术类书籍')
💣 Excel 存储的三个硬伤:
- 性能地狱:Excel 文件的读写速度比 CSV 慢几十倍。如果你在爬虫的
for循环里,每爬一条数据就执行一次to_excel,你的硬盘 IO 会疯掉,程序会慢得像蜗牛。正确做法是:攒够 1000 条数据,再批量写入一次。 - 容量天花板:老生常谈的限制,单张 Sheet 最多容纳 1,048,576 行。超过这个数字,写入直接报错
ValueError。 - 格式干扰:如果你爬取的是纯数字的“身份证号”或“长订单号”,Excel 会自作聪明地把它转成科学计数法(如
1.23E+17),最后几位精度直接丢失。在写入时,必须强制指定列的类型为字符串。
方案三:MySQL 数据库 —— 百万级数据与持久化的基石
当你开始构建分布式爬虫(比如用 Scrapy-Redis),或者数据量突破百万级,文件存储就彻底失效了。这时候关系型数据库 MySQL 必须出场。结构化存储也是进行后续数据分析的前提。如果你未来打算把这些数据喂给算法模型,强烈建议阅读一下这份 Python AI 入门:2026 完整学习路径。
优雅写入与防重复
用 pymysql 连接数据库是常识,但我这里要分享的是“如何防止重复插入数据”。爬虫经常因为断点续爬导致数据重复。
import pymysql

# 建立连接
conn = pymysql.connect(host='localhost', user='root', password='pwd', database='spider_db')
cursor = conn.cursor()

# 假设我们的表有唯一索引 (url_hash)
sql = """
 INSERT INTO article_data (title, author, url_hash)
 VALUES (%s, %s, %s)
 ON DUPLICATE KEY UPDATE
 title = VALUES(title);
"""

# executemany 实现极速批量插入
data_batch = [
 ('标题1', '作者A', 'hash_001'),
 ('标题2', '作者B', 'hash_002')
]

try:
 cursor.executemany(sql, data_batch)
 conn.commit()
except Exception as e:
 conn.rollback()
 print(f"入库失败: {e}")
finally:
 cursor.close()
 conn.close()
💣 内行细节提示:
- 千万别忘了
commit():太多新手跑完代码,发现数据库是空的,到处求助。MySQL 默认开启事务,不执行conn.commit()数据是不会落盘的。 - 连接池 (Connection Pool):如果是多线程爬虫,绝对不要共用一个数据库连接,会报
MySQL server has gone away。请使用DBUtils库创建数据库连接池。
方案四:MongoDB —— 结构混乱数据的救星
如果让我投票选出“爬虫工程师最喜欢的数据库”,MongoDB 绝对高票当选。
为什么?因为网页的数据结构太特么多变了。 昨天抓取的页面只有“商品名”和“价格”;今天改版了,多出了“满减活动”和“店铺评分”;明天又变成了嵌套的“评论列表”。如果用 MySQL,你得天天执行 ALTER TABLE 加字段。而 MongoDB 是 NoSQL(非关系型),存的是类似 JSON 的 BSON 格式。
多一个字段?少一个字段?有深层嵌套字典?MongoDB 照单全收,完全不需要提前建表。
实战代码
import pymongo

# 连接本地MongoDB
client = pymongo.MongoClient("mongodb://localhost:27017/")
db = client['spider_db']
collection = db['amazon_products']

# 爬到的复杂嵌套数据
item = {
 "product_id": "B08N5WRWNW",
 "name": "MacBook Air",
 "specs": {
 "ram": "8GB",
 "storage": "256GB SSD"
 },
 "reviews": ["Good", "Battery is awesome"]
}

# 简单粗暴,直接插入
collection.insert_one(item)
💣 核心实战技巧:
MongoDB 的防重复机制是通过 _id 字段实现的。如果你不指定,系统会自动生成一段 ObjectId。为了避免爬虫抓到重复数据,你可以强行把目标数据的唯一标识(比如商品URL或者MD5值)赋值给 _id 字段。这样只要插入重复数据,MongoDB 就会抛出 DuplicateKeyError,你只需要用 try...except 捕捉并 pass 掉即可。
终极检查清单 (The “Zero-Loss” Checklist)
在你将爬虫部署到服务器并点击 Run 之前,请对照以下清单检查你的数据存储逻辑:
- 是否有容灾机制? 不要把所有数据存在一个 List 里等最后保存。要么每满 1000 条落地一次(Chunk 模式),要么改用实时流式写入。
- 是否处理了特殊字符? 网页上的表情符号(Emoji)、零宽字符(
\u200b)极易导致 CSV 错位或 MySQL 报错。入库前是否做了re.sub()清洗? - 数据库是否添加了唯一索引(Unique Index)? 这是防止增量爬虫产生大量脏数据的最后一道防线。
- 文件路径是否为绝对路径? 用定时任务(如 crontab)跑爬虫时,相对路径极容易把数据存到未知的根目录下。
FAQ (常见问题解答)
Q1: 爬到的图片和视频文件,存进 MySQL 还是 MongoDB? 答: 都不存。数据库绝对不要用来直接存大型二进制文件(Blob),会导致查询性能断崖式下跌。正确的做法是:把图片保存到本地硬盘或云存储(如阿里云OSS),然后把图片的URL路径或本地路径作为字符串,存进数据库里。
Q2: 数据量大约500万条,用 CSV 还是数据库? 答: 必须上数据库(MySQL、PostgreSQL或MongoDB)。虽然 CSV 也能存500万条,但当你想要在 CSV 里“查询价格大于100的特定商品”时,你只能写脚本遍历整个文件,耗时极长。数据库的索引机制能在毫秒级完成这类查询。
Q3: 为什么用 pandas 写入 CSV 时,第一列总是多出一个毫无意义的数字索引(0, 1, 2…)? 答: 这是 pandas 的默认行为。在导出时,必须加上参数 index=False(如 df.to_csv('data.csv', index=False)),这样那个烦人的行号列就会消失了。
权威参考与扩展阅读: