爬虫抓到的数据只有写入数据库并核对结果,才算完成了存储流程。Python 自带 sqlite3 模块,不必另行安装;本文以模拟的网页抓取记录为例,演示连接数据库、建表、批量写入、更新、删除和查询,也说明数据未按预期保存时该检查什么。
这篇 python sqlite3教程 适合刚接触 python数据库入门 的读者。我们会把数据库操作集中在一个示例中,方便你看清每一步如何衔接。有关连接、游标、参数和事务的详细说明,可查阅Python 官方 sqlite3 文档。若要先了解爬虫流程,可阅读爬虫入门步骤;本文只讨论如何存取抓取结果。
连接 SQLite 数据库
调用 sqlite3.connect("crawler.sqlite3") 可以打开数据库文件;如果指定的文件尚不存在,SQLite 会创建它。相对路径以程序运行时的当前工作目录为基准,因此数据库文件不一定与 Python 代码放在同一目录。
连接对象负责管理数据库连接和事务,游标则用于执行 SQL 并读取查询结果。以下示例使用 Path.cwd() 明确指定数据库文件所在位置。
建表并用唯一约束避免重复网址
示例记录网页地址、标题和抓取时间。id 是每条记录的主键,url 设为唯一值,以免相同网址重复写入。SQLite 官方文档介绍了建表语法及主键、唯一约束。
| 字段 | 用途 | 约束 |
|---|---|---|
id |
记录编号 | 主键 |
url |
页面网址 | 唯一 |
title |
页面标题 | 无 |
fetched_at |
抓取时间 | 无 |
CREATE TABLE IF NOT EXISTS 会在表尚不存在时创建表;重复运行程序时,如果表已经存在,也不会因此报错。
批量写入,并决定如何处理重复记录
executemany 可以用同一条插入语句处理多条记录。每个元组中的值按顺序对应 SQL 里的问号占位符。示例使用 ON CONFLICT(url) DO NOTHING,遇到重复网址时不再插入。
如果重复网址出现时需要更新标题,应设定明确的更新规则,而不是直接忽略冲突。后面的 UPDATE 语句会演示如何按网址修改记录。
提交事务后再核对写入结果
执行写入语句不等于事务已经提交。调用 commit() 后,当前事务的修改才会提交;如果程序在提交前结束,不要仅凭插入语句已经执行,就认定记录已保存。
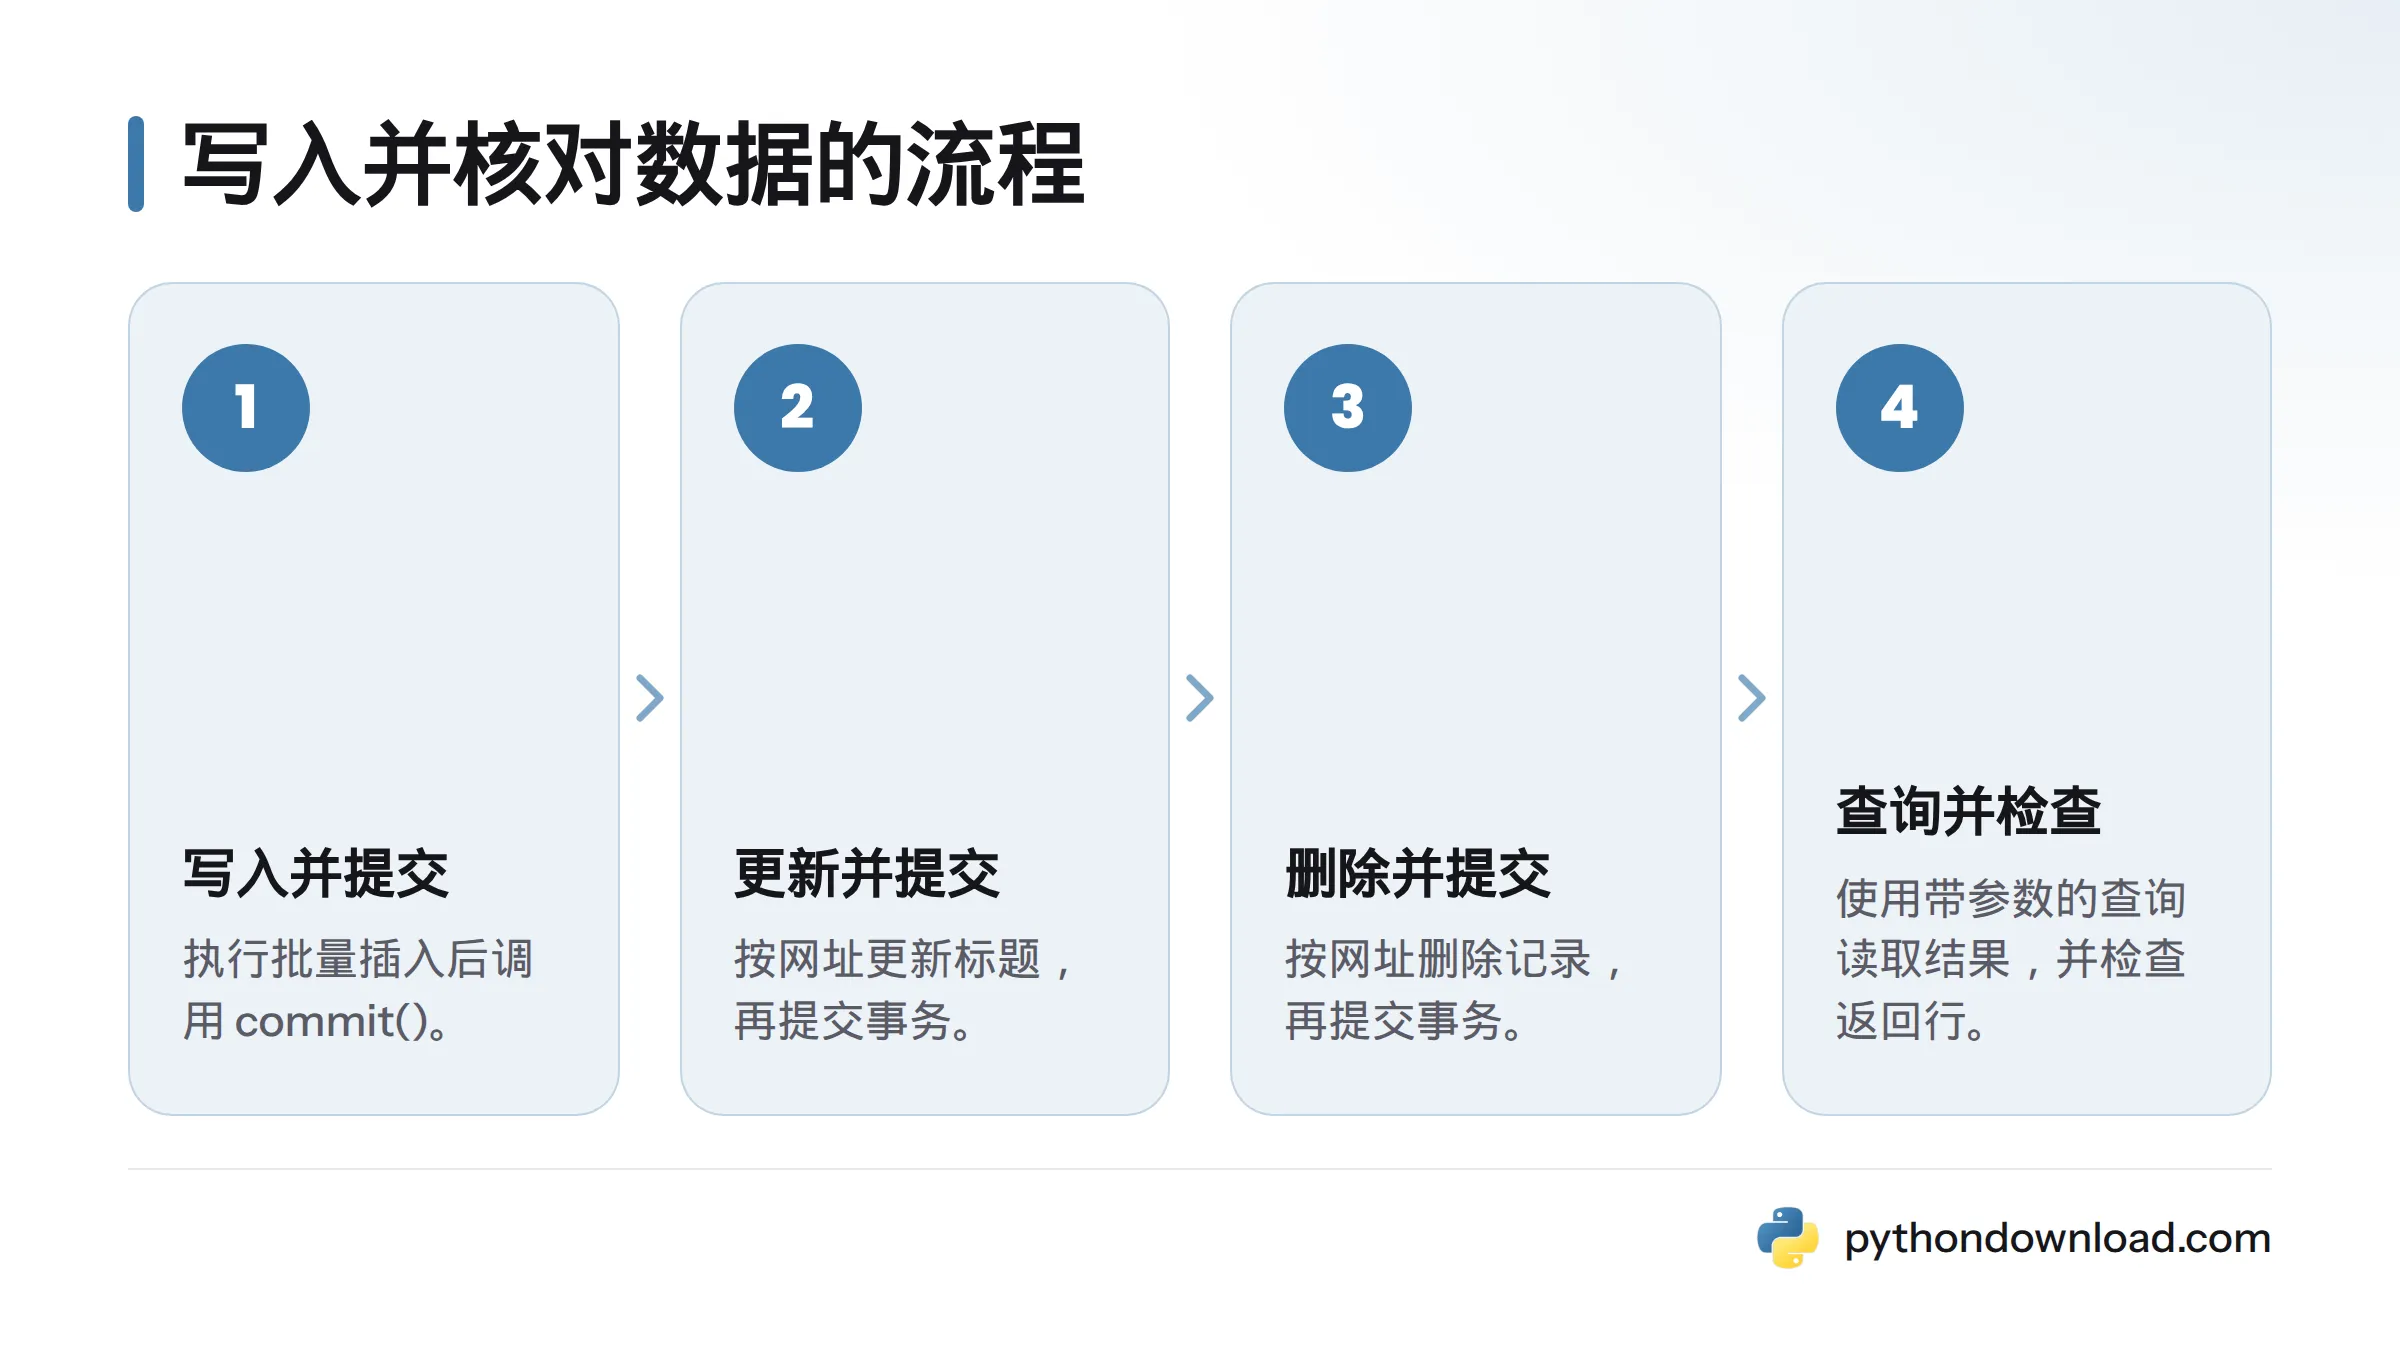
查询条件也应作为参数传入,而不是把网址或其他数据直接拼进 SQL 文本。占位符 ? 与参数元组中的值按顺序对应。fetchall() 会取回当前查询的全部结果;这里虽然只查询一个网址,仍用它读取并检查结果集。
import sqlite3
from pathlib import Path

# 数据库文件位于程序启动时的当前工作目录
db_path = Path.cwd() / "crawler.sqlite3"
conn = sqlite3.connect(db_path)
cursor = conn.cursor()

try:
    cursor.execute("""
        CREATE TABLE IF NOT EXISTS pages (
            id INTEGER PRIMARY KEY,
            url TEXT NOT NULL UNIQUE,
            title TEXT NOT NULL,
            fetched_at TEXT NOT NULL
        )
    """)

    records = [
        ("https://example.com/python", "Python 入门", "2026-11-11 09:00:00"),
        ("https://example.com/sql", "SQL 基础", "2026-11-11 09:05:00"),
        ("https://example.com/python", "重复网址记录", "2026-11-11 09:10:00"),
    ]

    cursor.executemany("""
        INSERT INTO pages (url, title, fetched_at)
        VALUES (?, ?, ?)
        ON CONFLICT(url) DO NOTHING
    """, records)
    conn.commit()

    # 更新:用网址定位记录,并通过占位符传入新标题
    cursor.execute(
        "UPDATE pages SET title = ? WHERE url = ?",
        ("Python 入门指南", "https://example.com/python"),
    )
    conn.commit()

    # 删除:示范按网址删除一条记录
    cursor.execute(
        "DELETE FROM pages WHERE url = ?",
        ("https://example.com/sql",),
    )
    conn.commit()

    cursor.execute(
        "SELECT url, title, fetched_at FROM pages WHERE url = ?",
        ("https://example.com/python",),
    )
    rows = cursor.fetchall()
    for row in rows:
        print(row)
finally:
    cursor.close()
    conn.close()
运行后,查询会返回标题已更新的 Python 页面记录。重复网址不会新增第二条记录,SQL 语句与参数也始终分开传入。若只需新增和核验数据,可以删去示例中的更新、删除语句。执行 UPDATE 或 DELETE 时,应设置合适的筛选条件,避免误改或误删其他记录。
这个例子集中展示了 python操作sqlite 的常用步骤,也包含 sqlite建表 和 sqlite增删改查。初学者可以先运行示例,再逐项调整查询条件和记录内容。
关闭连接并排查常见问题
任务结束后,应关闭游标和连接。示例使用 finally 执行收尾操作,因此即使运行时发生异常,程序也会尝试关闭它们。若还要学习爬虫的数据采集流程,可参考爬虫数据采集与保存指南;Python 基础内容可从 Python 下载 的教程导航开始。
| 现象 | 优先检查 |
|---|---|
| 找不到数据库文件 | Path.cwd() 指向的当前工作目录,以及连接时使用的文件名 |
| 查询没有结果 | 表名、网址条件、插入语句是否执行,以及事务是否提交 |
| 插入后少了重复记录 | url 唯一约束和 ON CONFLICT 的处理方式 |
| 重新运行后数据不符合预期 | commit() 的位置,以及程序连接的数据库文件是否相同 |
常见问题
使用 sqlite3 前需要安装模块吗?
不需要。sqlite3 属于 Python 标准库。
数据库文件不存在时,connect 会怎么处理?
对普通文件路径调用 sqlite3.connect 时,如果文件不存在,程序会创建它。相对路径从当前工作目录解析。
插入后为什么还要调用 commit?
插入语句执行后,事务未必已经提交。调用 commit(),再通过查询读取记录,才能核对这次写入是否符合预期。
查询结果为空时,按什么顺序排查?
先确认连接指向的文件和表名,再核对插入的数据与查询条件,最后检查写入语句是否执行、事务是否提交。如果数据库文件看似消失,先打印 Path.cwd(),确认程序实际查找的位置。
怎样确认刚写入的数据已经保存?
提交事务后,执行带参数的 SELECT,调用 fetchall() 并检查返回的行。示例也用这套流程核对更新后的记录。
若还想了解其他爬虫数据存储方式,可阅读爬虫数据保存方式介绍。本文聚焦 Python 的 SQLite 增删改查;补充 Python 基础时,也可查看中文 Python 教程。
参考资料
Related: 爬虫数据保存的多种方式