Python 读取 TXT 文件的终极省流指南:
- 最推荐的现代写法 (上下文管理器):永远使用
with open('file.txt', 'r', encoding='utf-8') as f:,不用手动写f.close(),系统自动回收资源。- 小文件读取:
f.read()一次性读取全部内容为字符串;f.readlines()读取并返回按行划分的列表。- 大文件读取 (GB级别):绝对不要用上面两个!直接迭代文件对象
for line in f:,内存消耗近乎为零。- 终极防乱码:不要依赖系统默认编码。在
open()中永远显式声明encoding='utf-8'。如果遇到历史遗留的 GBK 文件,改为encoding='gbk'。
一、为什么 open() 总是报错?先弄懂上下文管理器
很多新手在写 Python 读取文件时,习惯像 C 语言那样写:
f = open("data.txt", "r")
content = f.read()
f.close()
这种写法在现代 Python 工程中被视为“高危操作”。一旦 f.read() 在执行时抛出异常(比如遇到不可预期的二进制数据),程序会直接崩溃,后续的 f.close() 永远无法执行。如果在高并发服务器上这么写,文件句柄(File Descriptor)很快就会被耗尽,导致系统级宕机。
实战防坑方案:强制使用 with 语句 从 Python中文官网 的 PEP 343 规范引入上下文管理器以来,标准的读取范式变成了:
with open("data.txt", "r", encoding="utf-8") as f:
 content = f.read()
# 离开缩进块后,Python 内部会自动调用 f.close(),即使发生异常也一样。
这不仅是代码风格的问题,更是保障系统稳定性的底层机制。
二、图文拆解:4 种读取颗粒度,到底该用哪个?
Python 提供了多种读取颗粒度,选错方法最直接的后果就是内存溢出 (OOM)。
1. read():简单粗暴的“一口吞”
- 适用场景:几兆以内的小文件,需要将全文当作一个大字符串进行正则表达式匹配。
- 痛点:如果文件有 5GB,你的程序会瞬间请求 5GB 内存,直接把服务器搞挂。
2. readlines():返回列表的“内存刺客”
- 适用场景:需要将每一行存为数组元素,方便后续通过索引(比如
lines[5])随机访问。 - 痛点:和
read()一样,它依然是一次性将文件全部加载到内存中。
3. readline():精准控制的“手动步枪”
- 适用场景:只想读取文件的前几行(比如表头),或者基于某种特定触发条件才读取下一行。
with open("data.txt", "r") as f:
 header1 = f.readline()
 header2 = f.readline()
4. 迭代文件对象:处理超大文件的“神器” (Information Gain)
很多老旧的教程会教你用 while f.readline(): 来逐行读取大文件,这其实是非常低效且啰嗦的写法。 在 Python 3 中,文件对象本身就是可迭代的 (Iterable)。这是处理 GB 级别日志文件时,唯一正确的选择。
# 处理 10GB 日志文件的正确姿势
with open("server_log.txt", "r", encoding="utf-8") as f:
 for line in f:
 # 内存中始终只保留当前读取的这一行,极其轻量
 if "ERROR" in line:
 print(line.strip()) # strip() 用于去除行尾默认的换行符 \n
三、深水区排错:让你抓狂的“乱码”与 UnicodeDecodeError
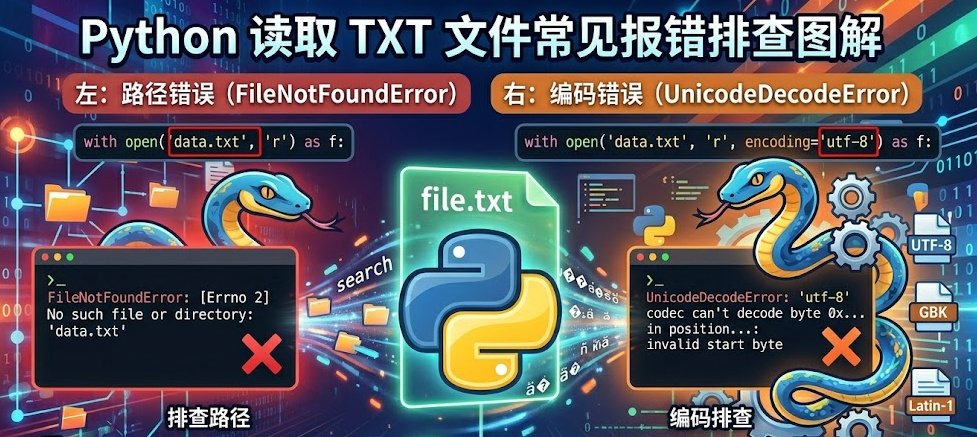
只要你做过国内的数据采集,100% 会遇到这个报错: UnicodeDecodeError: 'gbk' codec can't decode byte 0xad in position...
底层逻辑剖析
当你不写 encoding 参数时,Python 并不是默认使用 UTF-8,而是使用操作系统的默认编码。如果你在 Windows 上运行 Python,它会默认使用 GBK 去读取文件;而在 Linux 或 macOS 上,默认是 UTF-8。
如果你的 data.txt 是用 UTF-8 编码保存的,但你在 Windows 上不指定编码去读取,Python 就会用 GBK 的规则去强行解析 UTF-8 的二进制流,结果必然是报错或乱码。
终极解决策略
- 显式声明(最优解):永远加上
encoding='utf-8'。 - 暴力忽略错误:如果文件只有极少数损坏的乱码字符,你不希望程序中断,可以加入
errors='ignore'或errors='replace'。
# 遇到无法解码的字符直接跳过,不会报错
with open("dirty_data.txt", "r", encoding="utf-8", errors="ignore") as f:
 pass
四、高频踩坑:路径写法的“隐形墙”
当你尝试读取文件时,抛出 FileNotFoundError 是家常便饭。这往往是因为相对路径的基准目录混淆导致的。
特别是在大型项目中,你在 src/main.py 里运行代码,却想读取 data/config.txt,如果只是简单写相对路径,常常会找错地方。强烈建议深入了解 Python 文件系统的底层逻辑,参考这篇详尽的 Python文件路径怎么写?绝对路径与相对路径的底层逻辑梳理,学会利用 os.path 或现代的 pathlib 模块来动态构建绝对路径。
实战检查清单 (Checklist)
在把包含文件读取操作的 Python 脚本部署到生产环境之前,请对照检查:
- [ ] 防御性语法:是否使用了
with open(...) as f:替代了裸奔的open()? - [ ] 编码安全:
open()函数中是否显式声明了encoding='utf-8'或预期编码? - [ ] 内存评估:预估读取的文件大小。如果是大于 50MB 的日志或数据源,是否采用了
for line in f:迭代读取而不是直接f.read()? - [ ] 换行符处理:如果使用了逐行读取,后续业务逻辑中是否考虑了使用
line.strip()来移除行尾多余的\n或\r\n?
FAQ (常见问题解答)
Q1:为什么我用 f.read() 读取之后,再执行一次 f.read() 得到的是空字符串? A:Python 读取文件是有“文件指针(Cursor)”概念的。当你第一次执行 read() 后,指针已经移动到了文件最末尾。如果你想重新读取,需要使用 f.seek(0) 将指针强制移回文件开头。
Q2:读取带有 BOM 头的 UTF-8 文件开头有个奇怪的字符(\ufeff),怎么去掉? A:这是 Windows 记事本等软件保存 UTF-8 文件时喜欢附加的不可见签名(BOM)。在 open() 中将编码指定为 encoding='utf-8-sig',Python 会自动帮你把这个幽灵字符过滤掉。
Q3:我想同时读取和写入同一个 txt 文件,模式用 r+ 还是 w+? A:这是一个高危操作!w+ 会在打开文件的瞬间把原文件清空;r+ 虽然不会清空,但它的写入是指针覆盖操作,极其容易导致原有数据混乱。如果是修改文件,正规做法是:读取原文件数据 -> 在内存中修改 -> 覆盖写入原文件;或者采用更安全的方案:将修改后的内容写入一个临时文件 .tmp,最后利用 os.replace 替换掉原文件。