遍历序列时,如果既要处理元素,又要知道它的位置,enumerate() 可以一次提供索引和值。它省去手动维护计数器的代码,适用于列表、字符串、文件等可迭代对象。
刚开始学习 Python,可以接着阅读Python 中文教程熟悉循环和序列;需要安装运行环境时,可查看 Python 下载入口中的相关指南。
enumerate() 的基本用法
enumerate(iterable, start=0) 会返回一个可迭代的枚举对象。每轮遍历产生一组“索引、元素”,默认索引从 0 开始。
fruits = ["苹果", "梨", "葡萄"]

for index, fruit in enumerate(fruits):
    print(index, fruit)
输出:
0 苹果
1 梨
2 葡萄
循环每次接收一个二元组,例如 (0, "苹果")。这里的 index 和 fruit 分别接收索引与元素值。Python 官方文档将 enumerate() 定义为返回枚举对象的内置函数,参数形式见内置函数 enumerate,Python 官方文档。
枚举对象不是列表。若确实需要保存所有配对结果,可以用 list() 转换:
pairs = list(enumerate(["红", "蓝", "绿"]))
print(pairs)
# [(0, '红'), (1, '蓝'), (2, '绿')]
只需逐项处理时,直接遍历枚举对象即可,不必先转换成列表。
enumerate 起始值:让编号从 1 开始
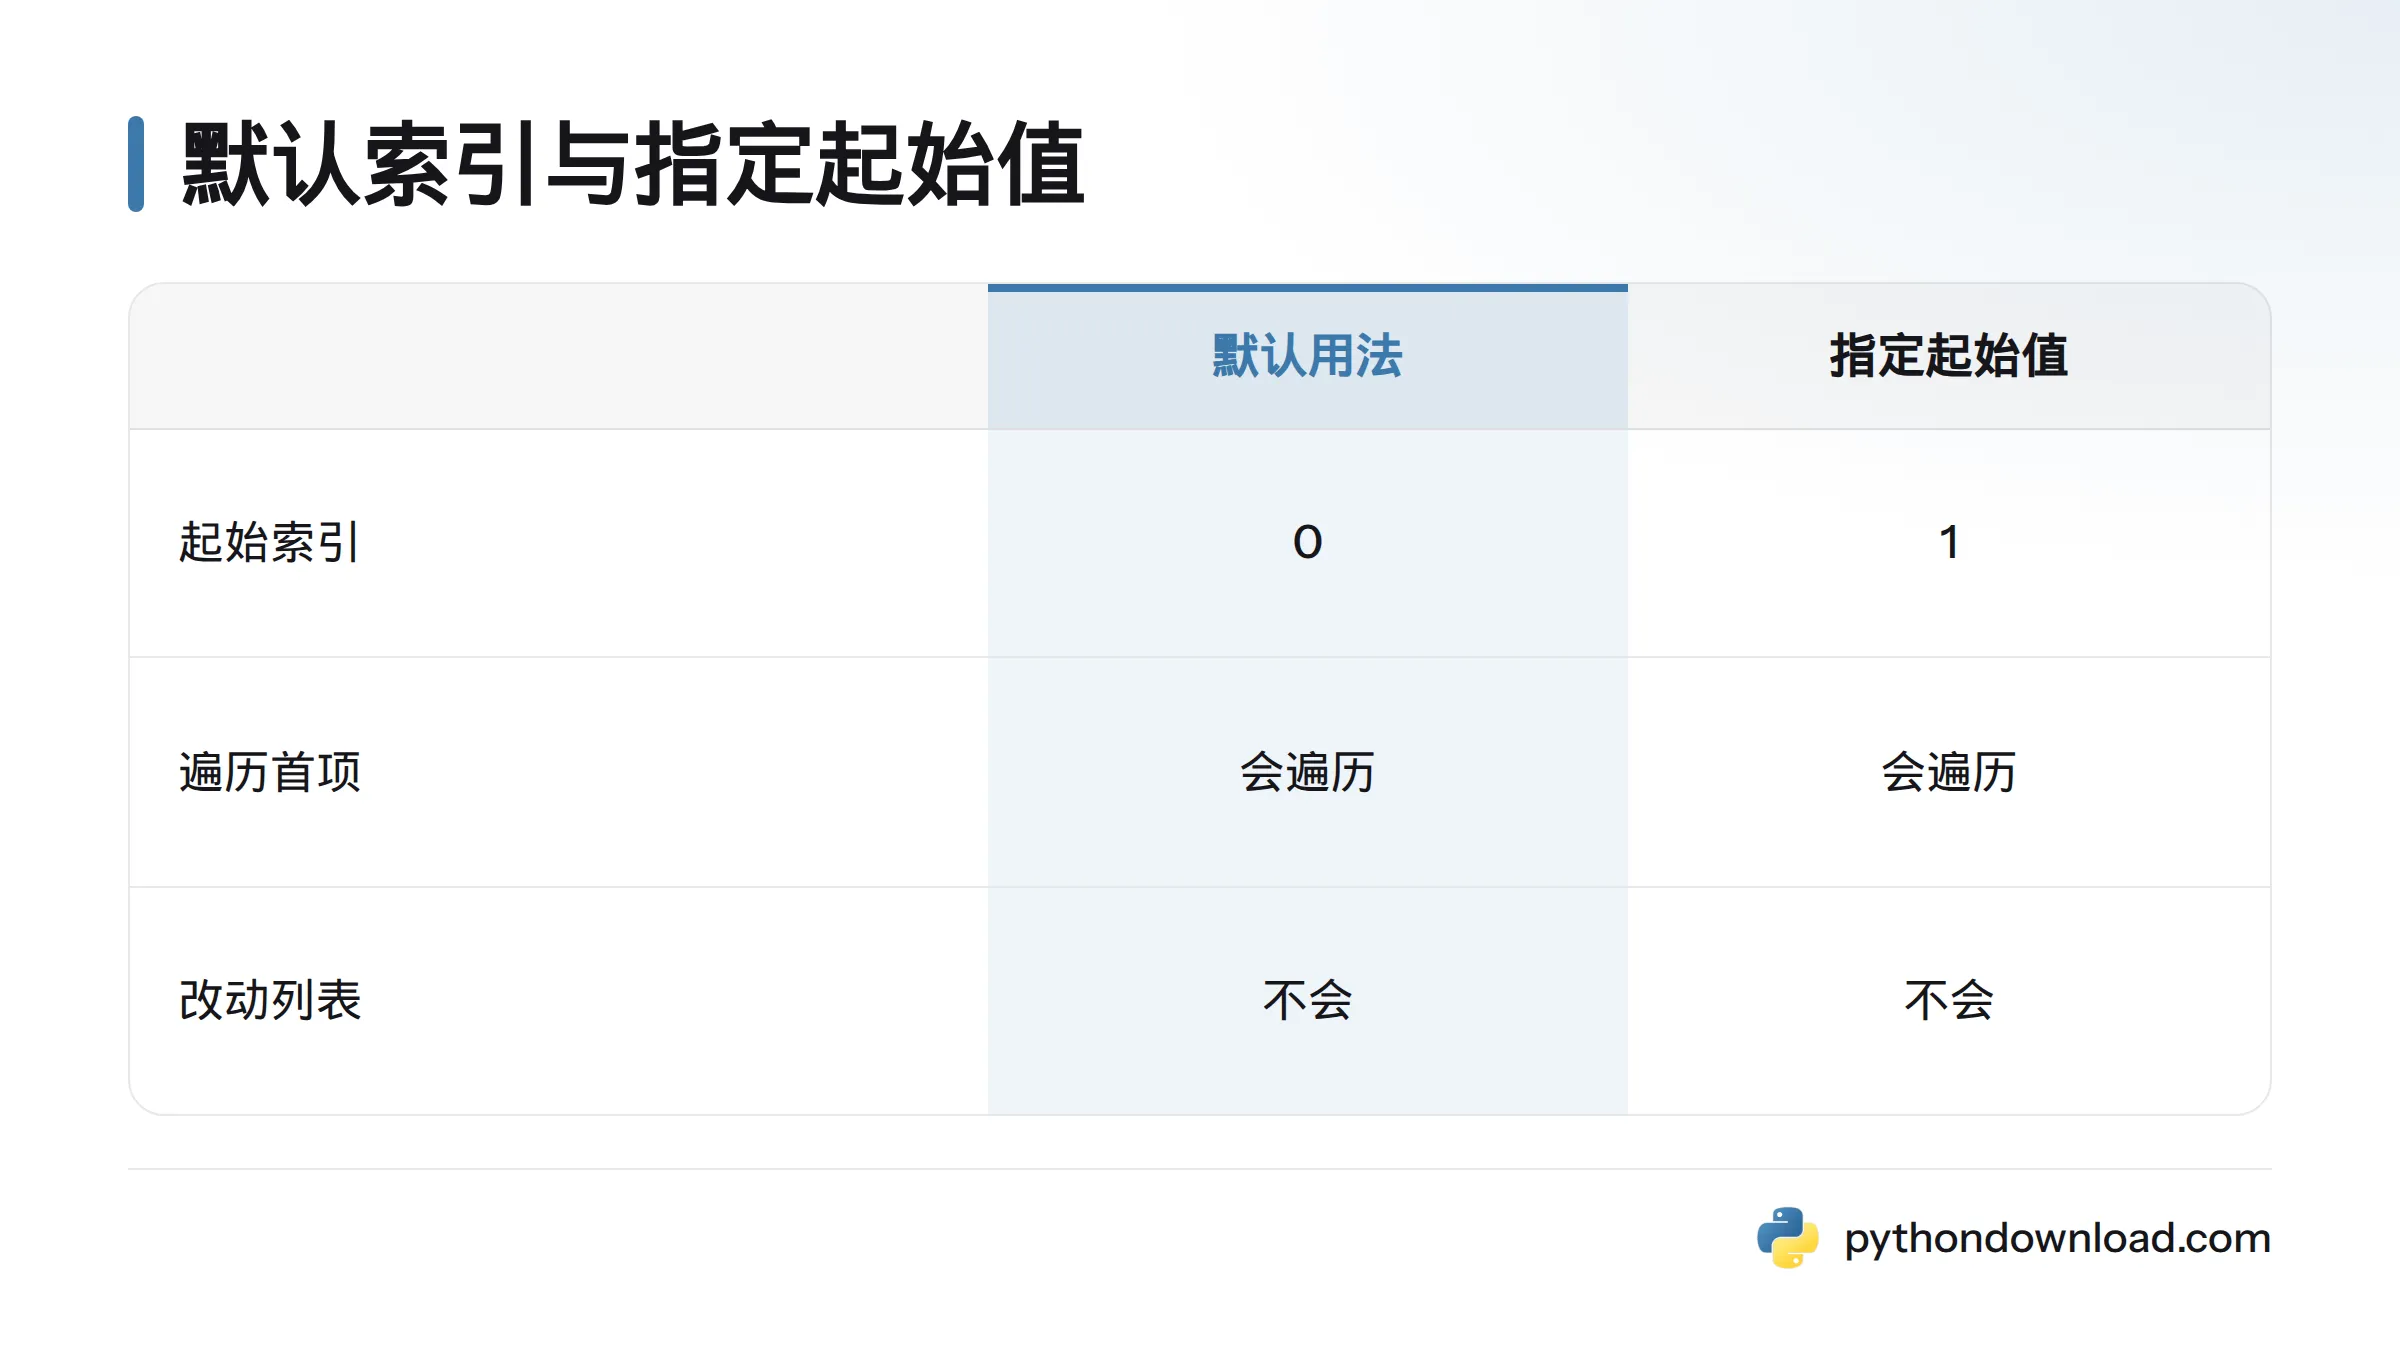
start 用来指定起始索引,默认值为 0。想按从 1 开始的序号打印任务清单,可以这样写:
tasks = ["整理文件", "检查邮件", "提交报告"]

for number, task in enumerate(tasks, start=1):
    print(f"{number}. {task}")
输出:
1. 整理文件
2. 检查邮件
3. 提交报告
start=1 只改变生成的索引,不会改动列表,也不会跳过第一项。enumerate(tasks, 1) 与 enumerate(tasks, start=1) 效果相同;写出参数名能让用途一目了然。
常见用法包括给清单或步骤编号、在错误信息中标出行号,以及为记录生成从一开始的展示序号。
for 循环获取索引:enumerate() 和 range(len()) 对比
range(len(items)) 先生成索引,再通过索引读取元素。enumerate(items) 则在遍历时直接提供索引和值。若只处理元素本身,写成 for value in items 最简单;需要索引和值时,enumerate() 通常更直观。
| 写法 | 每轮得到的内容 | 适用情况 |
|---|---|---|
for value in items |
元素值 | 只处理元素 |
for index, value in enumerate(items) |
索引和值 | 同时需要位置与元素 |
for index in range(len(items)) |
索引 | 通过索引读取或改写元素 |
下面两种循环都会打印索引和对应颜色:
colors = ["红", "黄", "蓝"]

for index, color in enumerate(colors):
    print(index, color)

for index in range(len(colors)):
    print(index, colors[index])
如果只想显示颜色,不必取索引:
for color in colors:
    print(color)
若要按索引改写原列表,可以使用 range(len()):
for index in range(len(colors)):
    colors[index] = "颜色:" + colors[index]
列表切片和逐项改写等内容,可接着阅读 Python 进阶语法与标准库指南。
遍历字符串、文件和其他可迭代对象
只要对象支持迭代,就可以交给 enumerate()。字符串会逐字符遍历,元组会逐项遍历,打开的文件对象则可以逐行读取。
word = "Python"

for index, character in enumerate(word, start=1):
    print(index, character)
也可以为文件内容标注行号:
with open("notes.txt", encoding="utf-8") as file:
    for line_number, line in enumerate(file, start=1):
        print(f"第{line_number}行:{line.rstrip()}")
rstrip() 会移除行尾的换行符,避免打印时多出空行。处理网页数据或记录列表时,也常会用到遍历技巧;可参阅 Python 爬虫入门指南中的数据处理内容。
enumerate 字典:得到的是键,不是键和值
直接遍历字典会逐项返回键。因此,enumerate(mapping) 产生的是“序号、键”,不会自动带上字典值。
scores = {"小林": 88, "小周": 92}

for index, name in enumerate(scores):
    print(index, name)
输出:
0 小林
1 小周
若要同时取得键和值,遍历 scores.items():
for index, (name, score) in enumerate(scores.items(), start=1):
    print(index, name, score)
每轮得到的结构是 (索引, (键, 值)),所以循环变量写作 index, (name, score)。Python 教程介绍了字典 items() 视图及相关遍历方式,可见循环技巧,Python 官方教程。
常见错误与检查方法
使用 enumerate() 时,先确认每轮循环拿到的数据结构,再决定如何拆分变量:
- 默认索引不是从 1 开始。 默认值为
0;需要展示序号时,指定start=1。 - 循环变量可能接收到二元组。
for item in enumerate(values):中的item是(索引, 元素),例如(0, "苹果"),不是单独的元素。 - 遍历字典时不会自动取得值。 普通遍历得到键;同时需要键和值时,使用
enumerate(data.items())。 - 循环时增删列表元素会改变遍历结果。 筛选数据时,通常先创建新列表,或遍历原列表的副本。
例如,enumerate(names) 每轮产生 (index, name);enumerate(scores.items()) 每轮产生 (index, (name, score))。把结构写清楚,再拆分变量,能更快发现解包错误。
常见问题
enumerate() 返回什么?
它返回一个枚举对象。对象可逐项遍历,每项由索引和对应元素组成。调用 list(enumerate(values)),可以将这些配对结果放进列表中查看。
enumerate() 的索引从几开始?
默认从 0 开始。传入 start=1 等起始值后,索引会从指定数字开始,但仍会遍历原对象的第一项。
enumerate() 可以用于元组和字符串吗?
可以。元组、字符串、列表和文件对象都支持逐项迭代,因此都能交给 enumerate()。字符串会按字符提供元素。
enumerate() 能直接遍历字典的值吗?
直接遍历字典会得到键。若要同时取得键和值,使用 enumerate(data.items());若只需要值,可以遍历 data.values(),此时每轮配对的是序号和值。