在 Python 的后台留言中,我们经常看到这样的求助:“我自学了Python,代码写得还行,但投出去的简历总是石沉大海。”
其实,对于技术岗位,尤其是 Python 开发者来说,简历的“生死线”往往不在于你的学历(虽然它很重要),而在于你的项目经验(Project Experience)。HR和技术面试官每天要看数百份简历,他们平均只会在一份简历上停留 6 到 10 秒。
在这短短的几秒钟里,如果你的项目经验写的是:“使用 Django 开发了一个博客系统,实现了增删改查功能”,那么很遗憾,你大概率会被归类为“培训班流水线产品”。
那么,Python 开发者简历项目经验怎么写才能脱颖而出?如何把平平无奇的代码经历包装成高大上的技术亮点?本文为你拆解 2026 年最受青睐的简历写法。
第一部分:核心法则——拒绝流水账,拥抱 STAR 原则
很多新手写简历最大的误区就是“写过程”而不是“写结果”。
-
❌ 错误写法:负责后端开发,编写 API 接口,修复 Bug,维护数据库。
-
✅ 正确逻辑:遇到了什么难题?用了什么技术?达成了什么效果?
这就是全球通用的 STAR 法则。在 Python 开发者的简历中,你需要这样应用:
-
Situation (背景):项目的规模是怎样的?是为了解决什么业务痛点?(例如:处理每天 100 万次的请求)。
-
Task (任务):你在其中扮演什么角色?(例如:核心后端开发,负责重构支付模块)。
-
Action (行动):这是最关键的部分。你用了 Python 的什么特性?引入了什么库?解决了什么技术难点?(例如:引入 Celery 异步处理,使用 Redis 缓存热点数据)。
-
Result (结果):量化!量化!量化!(例如:接口响应时间从 500ms 降低到 50ms,服务器成本节省 30%)。
专家提示:技术面试官其实更看重
Action和Result。他们想知道的不是“你会写代码”,而是“你能用代码解决问题”。
第二部分:不同领域的 Python 项目经验模板(直接抄作业)
Python 的应用领域极广,针对不同的岗位,你的简历侧重点必须不同。以下我们提供三个高频领域的“黄金模板”。
场景一:Python Web 后端开发 (Django/Flask/FastAPI)
JD 关键词:高并发、RESTful API、数据库优化、微服务。
优化前:
负责公司电商平台的后端开发,使用 Django 框架,完成了用户注册、登录和购物车功能。使用 MySQL 存储数据。
优化后 (满分模板):
项目名称:分布式电商平台重构 (核心开发者)
背景:原单体架构难以支撑双十一期间 5000 QPS 的并发流量,系统频繁崩溃。
行动:
基于 Django REST Framework 重构微服务架构,将用户、订单、支付模块解耦。
引入 Redis 集群 缓存高频商品数据,解决缓存雪崩与击穿问题。
使用 Celery + RabbitMQ 异步处理订单生成与邮件通知,削峰填谷。
针对 MySQL 慢查询进行
EXPLAIN分析,通过建立联合索引优化 SQL 语句。结果:系统成功抗住 10,000+ QPS 的峰值流量,接口平均响应时间下降 60%,并在高负载下保持 99.9% 的可用性。
解析:
这段描述展示了你不仅会用 Django,还懂架构、懂缓存、懂数据库优化,这才是中高级开发者的水平。
场景二:Python 爬虫与数据采集
JD 关键词:逆向工程、分布式爬虫、Scrapy、反爬策略、清洗。
优化前:
写了一个爬虫抓取某某网站的数据,保存到 Excel 里。
优化后 (满分模板):
项目名称:全网舆情数据实时采集系统
背景:需要实时监控 20+ 个主流新闻源及社交平台的舆情数据,日增量 50GB+。
行动:
搭建 Scrapy-Redis 分布式爬虫集群,部署在 10 台服务器上并行抓取。
破解 JS 逆向加密参数(如 Webpack 打包逻辑),绕过字体反爬和验证码验证。
构建 IP 代理池,设计自动切换与重试机制,将请求成功率提升至 98%。
使用 Pandas 进行数据清洗与去重,最终存入 MongoDB 和 Elasticsearch。
结果:实现了 日均 500 万条 数据的稳定采集,数据清洗效率提升 3 倍,为下游分析团队提供了高质量数据源。
场景三:数据分析与 AI 算法
JD 关键词:NumPy, Pandas, Sklearn, PyTorch, 模型调优。
优化前:
用 Python 分析了销售数据,画了几个图表,预测了下个月的销量。
优化后 (满分模板):
项目名称:用户流失预测模型 (User Churn Prediction)
背景:平台月度用户流失率较高,需要精准识别高风险用户并进行干预。
行动:
使用 Pandas/NumPy 处理 1TB+ 的用户行为日志,进行缺失值填充与特征工程(Feature Engineering)。
基于 XGBoost 和 LightGBM 算法构建分类模型,通过 GridSearch 进行超参数调优。
解决了样本不均衡问题(SMOTE 采样),并使用 Docker 将模型封装为 API 服务。
结果:模型 AUC 值达到 0.89,准确率比原规则系统提升 25%,帮助运营团队挽回了约 5% 的潜在流失用户。
第三部分:简历中那些“隐形加分项”
除了具体的项目,还有哪些细节能让面试官眼前一亮?
1. 强调“技术深度”而非“技术广度”
不要在简历上罗列你听说过的所有技术(Python, Java, C++, Go…)。对于 Python 岗位,精通 Python 的生态(GIL 锁、装饰器、生成器、内存管理)比懂一点点 Java 重要得多。
如果你对自己的基础知识是否扎实不够自信,建议刷一下我们整理的 Python 面试题及答案解析(2026最新版):从基础到架构师,把这些底层原理融入到你的项目描述中。
2. 展示“工程化”能力
现在的公司不缺会写脚本的人,缺的是能写出“可维护代码”的工程师。在项目经验中,尽量提及:
-
Git 版本控制:Git Flow 工作流。
-
Docker 容器化:编写 Dockerfile,使用 K8s 部署。
-
CI/CD:使用 Jenkins 或 GitLab CI 自动化测试与部署。
-
代码规范:遵循 PEP8,使用 Pylint 进行代码检查。
3. 证书与开源贡献
虽然项目经验是王道,但如果你有高质量的开源项目(GitHub Star 数 > 50),或者拥有权威认证,这绝对是杀手锏。
很多同学会问:需不需要考个证来证明自己?这取决于你考的是什么证。关于这一点的深度分析,请阅读我们的专栏文章:Python有含金量高的官方证书吗?2026年程序员考证避坑指南。一个高含金量的证书(如 PCPP)配合扎实的项目,能让你在简历筛选阶段通过率翻倍。
第四部分:没有项目经验怎么办?(针对应届生/转行者)
这是 Python被问到最多的问题。如果你是转行者或应届生,确实没有商业项目经验,该怎么写?
切记:千万不要造假! 技术圈子很小,面试官问两句细节就会露馅。
解决方案:
-
高仿名企项目(Clone Projects):
不要写“图书管理系统”。去 GitHub 上找一些高质量的开源项目(比如仿 Instagram 的后端,仿知乎的问答社区),自己从头到尾写一遍。在简历中注明“基于 Django 实现的类 Instagram 社交后端”。
参考资源:GitHub 上的 Awesome Python 列表 是寻找灵感和库的绝佳去处。
-
参与开源贡献 (Open Source):
哪怕只是给知名的 Python 库修复了一个文档拼写错误(Typo),或者提交了一个小的 Bug Fix,都可以在简历上写:“Pandas/Flask 开源社区贡献者”。这比任何虚构的项目都更有说服力。
-
数据化你的“玩具项目”:
哪怕你只写了一个脚本自动下载壁纸,也可以包装得很好:“编写多线程爬虫脚本,解决 GIL 锁限制,将图片下载速度提升 500%”。
第五部分:排版与 ATS 优化(让机器读懂你的简历)
在 2026 年,大多数中大型企业都使用 ATS (Applicant Tracking System) 系统来自动筛选简历。如果你的简历格式不规范,可能根本送不到 HR 手里。
-
关键词密度:确保 JD 中的关键词(如 Python, SQL, Linux, AWS)在你的项目经验中自然出现。
-
文件格式:永远使用 PDF,不要用 Word。PDF 能保证在任何设备上排版不乱。
-
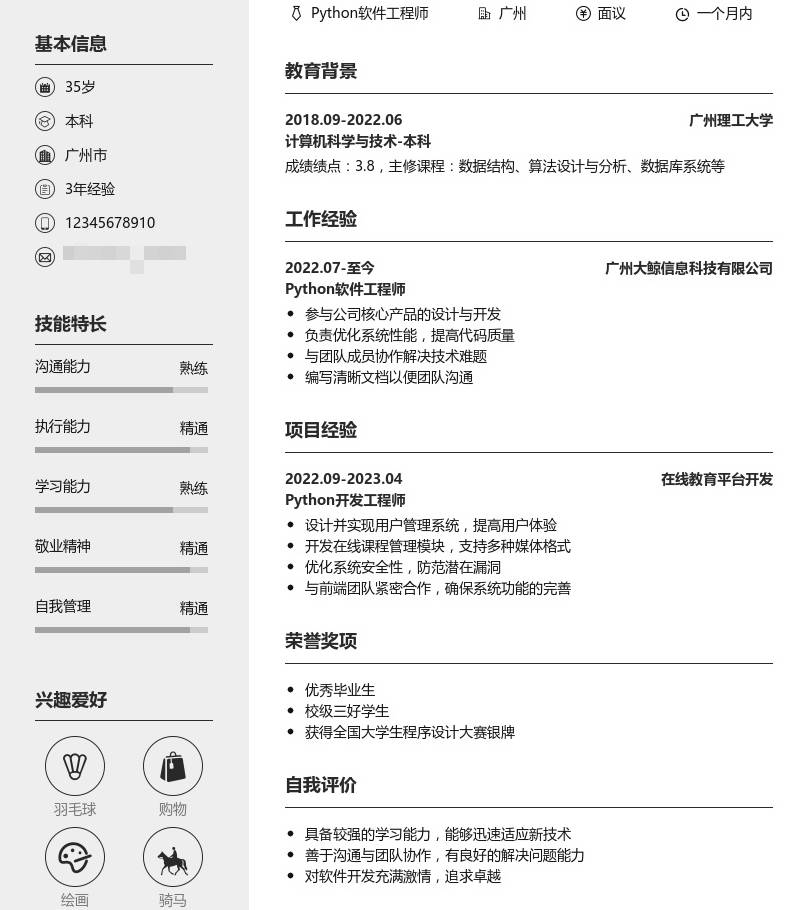
简洁明了:不要使用花哨的图标、进度条(比如 Python 能力:80%)。直接用文字描述项目。
-
排版结构:
-
项目名称(加粗) | 担任角色 | 时间
-
技术栈:Python 3.9, Django, MySQL, Redis(单独一行,方便 ATS 抓取)
-
项目描述:(1-2句话)
-
核心职责:(3-4点,使用 bullet points)
-
想要了解更多关于技术简历的排版规范,可以参考 Indeed 的技术简历写作指南,里面有详细的格式建议。
结语:简历是敲门砖,技术是硬通货
Python 开发者简历项目经验怎么写,本质上是一个“翻译”的过程——把你对代码的理解,翻译成对业务价值的贡献。
记住,一份好的简历是改出来的。写完后,对着上面的模板,问自己三个问题:
-
我看懂自己做了什么吗?
-
我有数据支撑我的成果吗?
-
我用到的技术栈够主流、够深入吗?
当你能自信地回答这三个问题时,你就已经一只脚迈进了大厂的门槛。现在,打开你的编辑器,开始重构你的简历吧!祝你在 2026 年的求职季中,Offer 拿到手软!